Un assistente di intelligenza artificiale che risponde utilizzando contratti, manuali, ticket o policy interne può far risparmiare ore di ricerca. Ma può anche trasformarsi in un canale per introdurre istruzioni malevole, alterare raccomandazioni o rivelare informazioni che un utente non dovrebbe vedere.
Il rischio emerge quando l’azienda dà per scontato che ogni documento consultato dalla propria IA sia affidabile. La sicurezza nei sistemi RAG richiede di proteggere le fonti, i permessi e le risposte: un file apparentemente legittimo può influenzare il risultato senza modificare il modello di intelligenza artificiale.
Esperti nella Rimozione di Ransomware
Affidati ai nostri professionisti certificati: oltre 25 anni di esperienza nel campo della rimozione di ransomware, recupero dati e sicurezza informatica.
Che cos’è un sistema RAG e perché ha bisogno di sicurezza
RAG significa Retrieval-Augmented Generation, ovvero generazione aumentata tramite recupero. Invece di rispondere solo con ciò che ha appreso durante l’addestramento, il modello cerca frammenti pertinenti in una knowledge base e li incorpora nel contesto della risposta.
Questa base può contenere file PDF, wiki, email, documentazione tecnica o repository aziendali. Proteggere queste fonti fa parte della cybersecurity nell’era dell’IA.
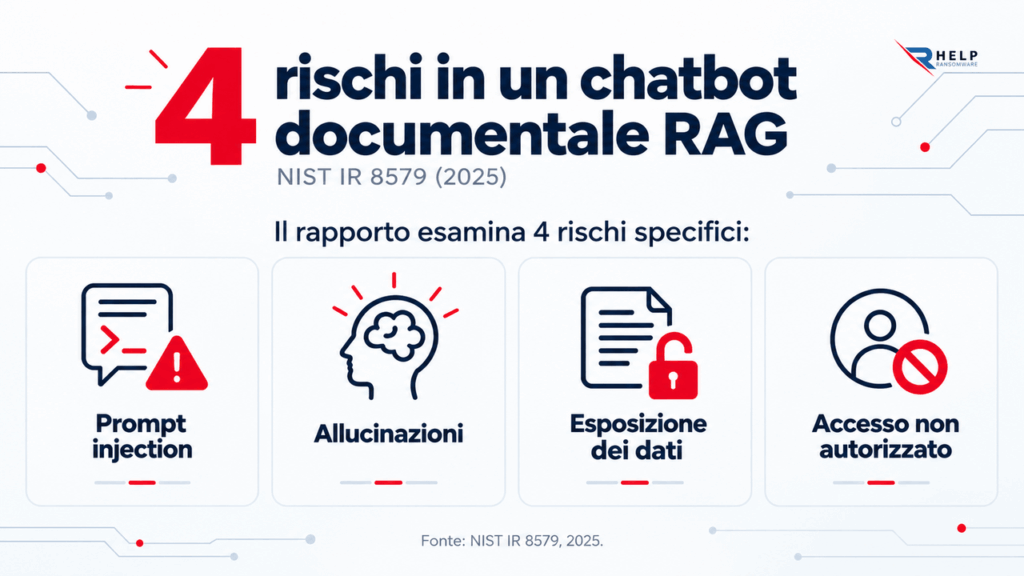
Il NIST ha documentato nel 2025 la realizzazione di un chatbot interno basato su RAG per consultare pubblicazioni di cybersecurity e ha evidenziato minacce come injection di istruzioni, risposte inventate, esposizione di informazioni e accessi non autorizzati.
Il suo rapporto sul chatbot del NCCoE mostra perché anche la progettazione di un motore di ricerca documentale debba essere valutata come un sistema di sicurezza.
La risposta dipende dai documenti e dai permessi
Il flusso tipico comprende diverse fasi: acquisizione dei file, suddivisione in frammenti, creazione di rappresentazioni vettoriali, recupero delle corrispondenze e generazione di una risposta.
Se la validazione, la classificazione dei file o il filtraggio per utente non funzionano correttamente, l’IA può recuperare contenuti alterati o informazioni al di fuori delle autorizzazioni dell’utente.
La sicurezza nei sistemi RAG non equivale a riaddestrare il modello: normalmente l’attaccante cerca di modificare le informazioni che il sistema consulta a ogni richiesta, non i suoi parametri interni. Per questo i controlli devono estendersi alla base documentale.
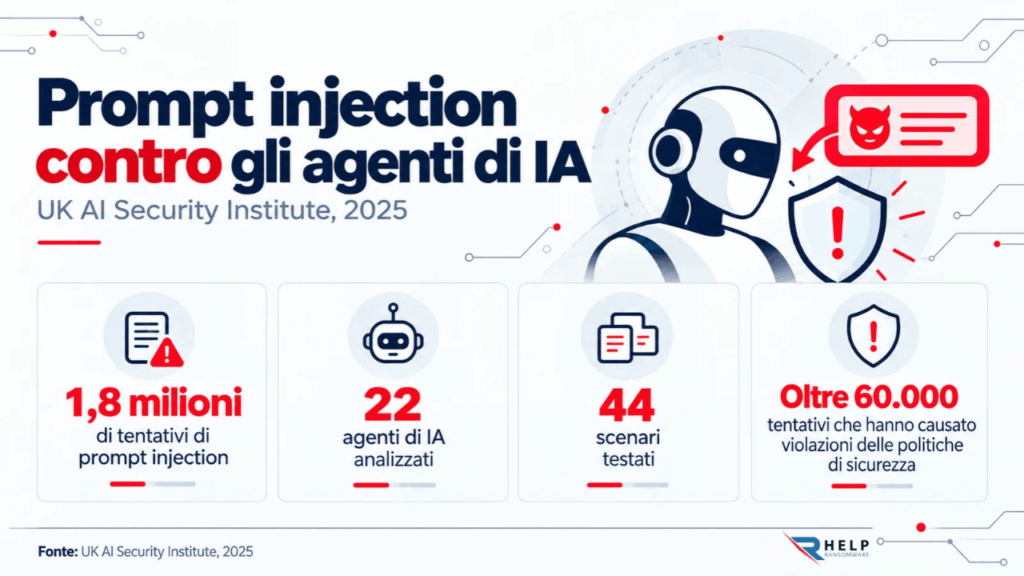
Come può un attaccante manipolare le risposte di un’IA RAG
Il punto di ingresso può essere un documento condiviso, una pagina web indicizzata, un ticket di assistenza o un allegato inserito nella knowledge base. Il contenuto sembra semplice materiale di consultazione, ma include istruzioni che cercano di prevalere sulle regole dell’assistente.
Se il sistema recupera quel contenuto senza controlli adeguati, il modello può seguire istruzioni dannose, alterare le risposte o trattare informazioni manipolate come affidabili.
Prompt injection indiretto nei file recuperati
Un’istruzione nascosta in un PDF potrebbe chiedere all’assistente di ignorare i criteri di approvazione degli acquisti o di fornire dati riservati. Il modello riceve quel testo come parte della documentazione recuperata e può confonderlo con un ordine legittimo. Questo schema è noto come prompt injection indiretto, una variante del prompt injection.
Il NCSC del Regno Unito spiega questa debolezza: i modelli linguistici non garantiscono una separazione tecnica rigorosa tra i dati forniti e le istruzioni da seguire. Un filtro di frasi sospette, da solo, non elimina il rischio.
Documenti contaminati e risultati distorti
Un’altra via è il data poisoning applicato alle fonti di recupero. L’attaccante può introdurre policy false, modificare date o sostituire la versione vigente di una procedura con una falsa.
Può anche caricare documentazione progettata per risultare particolarmente rilevante nelle ricerche. In questo modo, risposte errate possono apparire supportate da documentazione autorevole.
La differenza è importante: un documento manipolato non implica necessariamente che il modello sia stato riaddestrato. La contaminazione avviene nella knowledge base consultata. È una variante pratica del rischio analizzato nel data poisoning.
Rischi di sicurezza per i dati aziendali
La manipolazione delle risposte può avere conseguenze operative: un’IA per le risorse umane potrebbe interpretare in modo errato una procedura; uno strumento legale potrebbe citare una clausola inesistente; oppure un assistente di supporto potrebbe raccomandare modifiche non sicure.
Il problema aumenta quando queste risposte attivano azioni automatiche o vengono utilizzate senza verifica umana. Inoltre, contenuti manipolati possono favorire esposizione di dati sensibili, accessi non autorizzati o decisioni errate, ampliando l’impatto oltre il sistema di IA.
Fughe di dati causate da permessi e database vettoriali condivisi
In un ambiente con più reparti, la ricerca non deve mostrare frammenti solo perché corrispondono alla domanda. Deve verificare chi richiede le informazioni, quali documenti può consultare e se tali autorizzazioni sono ancora valide.
Un database vettoriale condiviso privo di controlli adeguati può mescolare tra utenti informazioni finanziarie, lavorative o contrattuali.
OWASP identifica queste debolezze come LLM08:2025 Vector and Embedding Weaknesses e raccomanda segmentazione logica, permessi granulari, validazione delle fonti e registri delle attività di recupero. La sua guida ufficiale sui rischi di vettori ed embedding è particolarmente rilevante per le applicazioni RAG aziendali.
Non basta nemmeno nascondere una risposta nell’interfaccia: i permessi devono essere applicati prima di recuperare i frammenti. Se il sistema riceve contenuto riservato nel proprio contesto, esiste già una potenziale esposizione che merita un’indagine.
Come rafforzare la sicurezza nei sistemi RAG
La prevenzione comincia prima che il documento raggiunga l’indice. L’azienda ha bisogno di un inventario delle fonti, responsabili della pubblicazione, classificazione della sensibilità e criteri chiari per accettare, modificare o rimuovere i file.
I test devono verificare sia l’accuratezza della risposta sia la possibilità di abuso. È inoltre importante applicare controlli di accesso, validazione dei documenti e monitoraggio continuo per individuare modifiche sospette o contenuti manipolati nella knowledge base.
Validare le fonti e controllare ogni aggiornamento
È opportuno mantenere versioni verificabili, validare i nuovi file, rilevare testo nascosto e conservare la tracciabilità di chi ha introdotto ogni modifica.
Quando una policy viene aggiornata, occorre rivedere i frammenti indicizzati per evitare che una versione precedente continui a comparire come vigente. La risposta può mostrare riferimenti, ma le citazioni non sostituiscono la verifica dell’autenticità.
Applicare il principio del minimo privilegio e limiti agli strumenti
Il motore di ricerca deve rispettare l’identità e i permessi originali dei repository. È preferibile suddividere gli indici per ambiti sensibili o applicare filtri di accesso verificati prima di fornire il contesto al modello.
Se l’assistente può inviare email, eseguire query o modificare record, queste azioni devono passare attraverso autorizzazioni tecniche indipendenti dal testo generato.
Misurare gli attacchi, registrare gli eventi e testare il ripristino
I test di sicurezza dovrebbero includere documenti con istruzioni avversariali, tentativi di consultazione tra reparti, risultati falsificati e richieste mirate a estrarre informazioni dall’organizzazione.
Registrare i documenti recuperati, le versioni, l’utente, la risposta e le azioni eseguite facilita l’identificazione del percorso di un incidente.
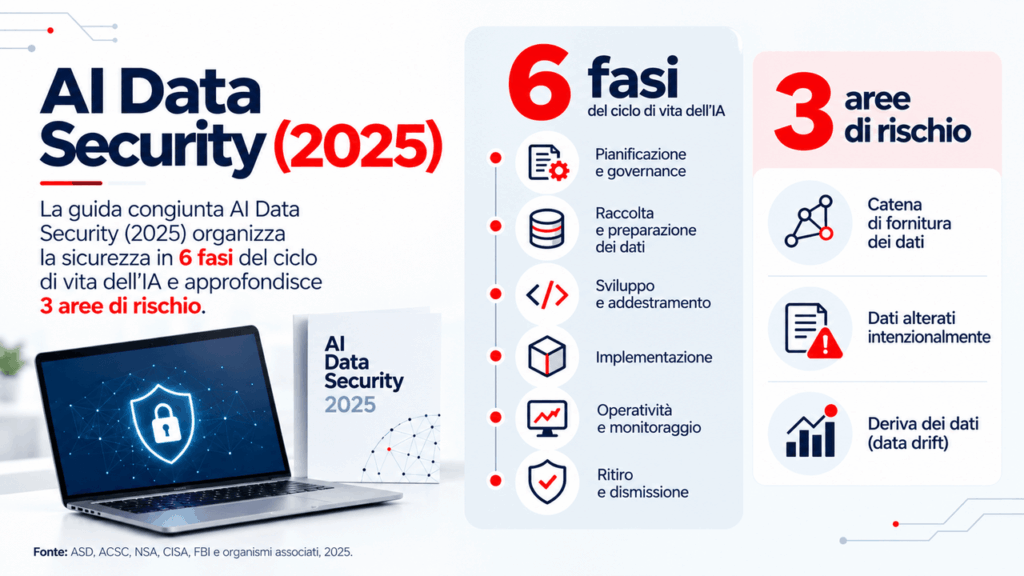
La guida congiunta sulla sicurezza dei dati per l’IA pubblicata nel 2025 da agenzie di Stati Uniti, Australia, Nuova Zelanda e Regno Unito sottolinea la necessità di proteggere i dati durante tutto il ciclo di vita, con validazione, controllo degli accessi, tracciabilità e monitoraggio continuo. Il documento è disponibile in AI Data Security, il portale ufficiale del Governo australiano.
Cosa fare se il tuo assistente RAG mostra già risposte manipolate
Se compaiono risposte anomale, citazioni impossibili o informazioni provenienti da altri reparti, è opportuno sospendere temporaneamente l’accesso alle fonti sospette e preservare le evidenze.
Il team deve identificare la query interessata, i frammenti recuperati, la loro provenienza e le identità che potrebbero aver ricevuto informazioni non autorizzate.
Successivamente occorre rimuovere o mettere in quarantena il contenuto compromesso, ricostruire gli indici necessari, rivedere i permessi e confrontare i risultati con documentazione autentica.
Se si è verificato un accesso indebito o una fuga di dati, il caso deve essere gestito come un incidente di sicurezza, attivando il piano di risposta agli attacchi informatici e i processi legali pertinenti.
Non basta modificare un’istruzione del chatbot e proseguire. Il ripristino richiede di confermare che la fonte alterata non compaia più, che gli indici siano stati aggiornati e che i test avversariali non riproducano il problema.

Soccorso Immediato per Ransomware
Il ransomware non deve paralizzare la tua attività. I nostri specialisti sono pronti a recuperare i tuoi dati e proteggere i tuoi sistemi.
Conclusione
Un sistema RAG può facilitare l’accesso alla conoscenza aziendale, ma permette anche ai contenuti esterni di influenzare direttamente ciò che l’IA risponde. Proteggere il modello senza proteggere documenti, permessi, vettori e registri lascia aperta un’importante superficie di attacco.
La sicurezza nei sistemi RAG si costruisce con fonti affidabili, controlli di accesso reali, test di manipolazione e un processo di risposta definito.
Per le organizzazioni che integrano l’IA nelle operazioni critiche, valutare questi controlli prima del deployment è importante quanto misurare l’utilità dell’assistente.
FAQ
Sì. È sufficiente che consulti documenti manipolati o non autorizzati perché una risposta possa essere compromessa. Il rischio risiede nel recupero e nell’uso dei contenuti, non necessariamente nell’addestramento. Per questo devono essere protette anche le fonti e i meccanismi che incorporano informazioni nel sistema.
No. Le citazioni aiutano a verificare ciò che è stato recuperato, ma anche una fonte può essere manipolata. È necessario validarne la provenienza ed evitare che il modello interpreti istruzioni nascoste come comandi. È inoltre opportuno limitare quali contenuti possono influenzare il comportamento del sistema durante il recupero.
Applicando controlli di accesso nella ricerca, collegati all’identità dell’utente e alle autorizzazioni reali su ciascun documento. L’interfaccia, da sola, non deve decidere quali frammenti vengono recuperati.
Non sempre. Devono essere eliminati anche i frammenti e i vettori derivati, aggiornati indici e cache, riesaminate le query interessate e verificato che il contenuto non compaia più nelle risposte. È inoltre necessario controllare che eventuali copie o versioni precedenti non restino accessibili al sistema.
La responsabilità è condivisa: l’IT gestisce infrastruttura e permessi; il team di sicurezza testa gli abusi e monitora; le aree proprietarie dei dati validano i contenuti; la direzione definisce la tolleranza al rischio e la supervisione.