Un asistente de inteligencia artificial que responde con contratos, manuales, tickets o políticas internas puede ahorrar horas de búsqueda. Pero también puede convertirse en una vía para introducir instrucciones maliciosas, alterar recomendaciones o revelar información que un usuario no debería ver.
El riesgo aparece cuando la empresa da por hecho que todo documento consultado por su IA es fiable. La seguridad en sistemas RAG exige proteger las fuentes, los permisos y las respuestas: un archivo aparentemente legítimo puede influir en el resultado sin modificar el modelo de inteligencia artificial.
Recuperación de Datos Rápida y Garantizada
HelpRansomware ofrece un servicio de eliminación de ransomware y recuperación de datos con garantía del 100%, con asistencia en todo el mundo 24/7.
Qué es un sistema RAG y por qué necesita seguridad
RAG significa Retrieval-Augmented Generation, o generación aumentada mediante recuperación. En vez de responder solo con lo aprendido durante su entrenamiento, el modelo busca fragmentos relevantes en una base de conocimiento y los incorpora al contexto de la respuesta.
Esa base puede contener archivos PDF, wikis, correos, documentación técnica o repositorios empresariales. Proteger estas fuentes forma parte de la ciberseguridad en la era de la IA.
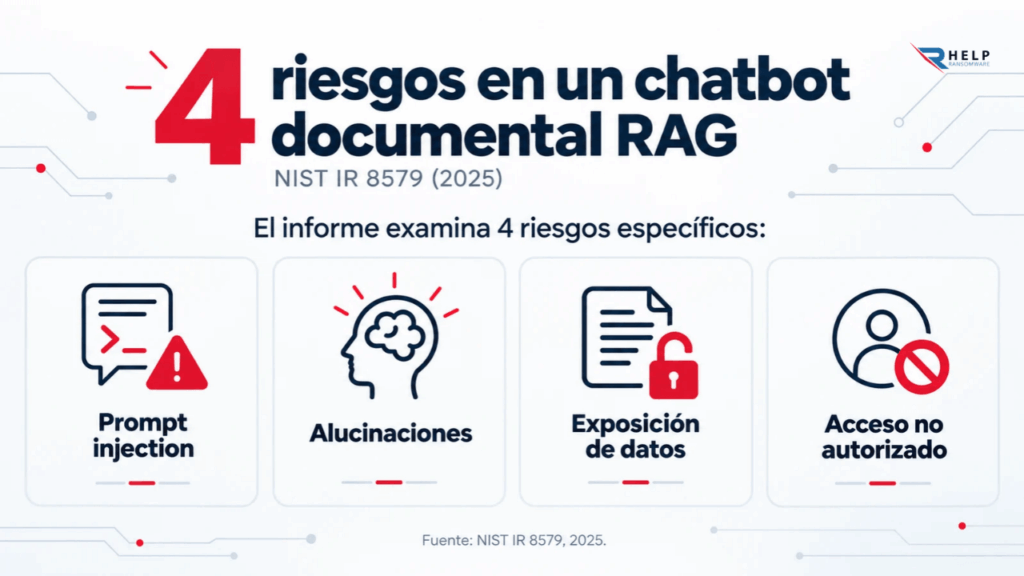
El NIST documentó en 2025 la construcción de un chatbot interno basado en RAG para consultar publicaciones de ciberseguridad y señaló amenazas como inyección de instrucciones, respuestas inventadas, exposición de información y accesos no autorizados.
Su informe sobre el chatbot del NCCoE ilustra por qué el diseño de un buscador documental también debe evaluarse como un sistema de seguridad.
La respuesta depende de documentos y de permisos
El flujo habitual tiene varias etapas: ingestión de archivos, división en fragmentos, creación de representaciones vectoriales, recuperación de coincidencias y generación de una respuesta.
Si fallan la validación, la clasificación de los archivos o el filtrado por usuario, la IA puede recuperar contenido alterado o información fuera de su autorización.
La seguridad en sistemas RAG no equivale a entrenar de nuevo el modelo: normalmente el atacante intenta modificar la información que este consulta en cada petición, no sus parámetros internos. Por eso, los controles deben extenderse a la base documental.
Cómo puede un atacante manipular las respuestas de una IA RAG
El punto de entrada puede ser un documento compartido, una página web indexada, una incidencia de soporte o un adjunto incorporado a la base de conocimiento. El contenido parece información de consulta, pero incluye instrucciones que pretenden desplazar las reglas del asistente.
Si el sistema recupera ese contenido sin controles suficientes, la IA puede priorizar instrucciones maliciosas, distorsionar respuestas o utilizar información manipulada como si fuera legítima.
Prompt injection indirecto en archivos recuperados
Una instrucción escondida en un PDF podría pedir al asistente que ignore el criterio de aprobación de compras o que entregue datos confidenciales.
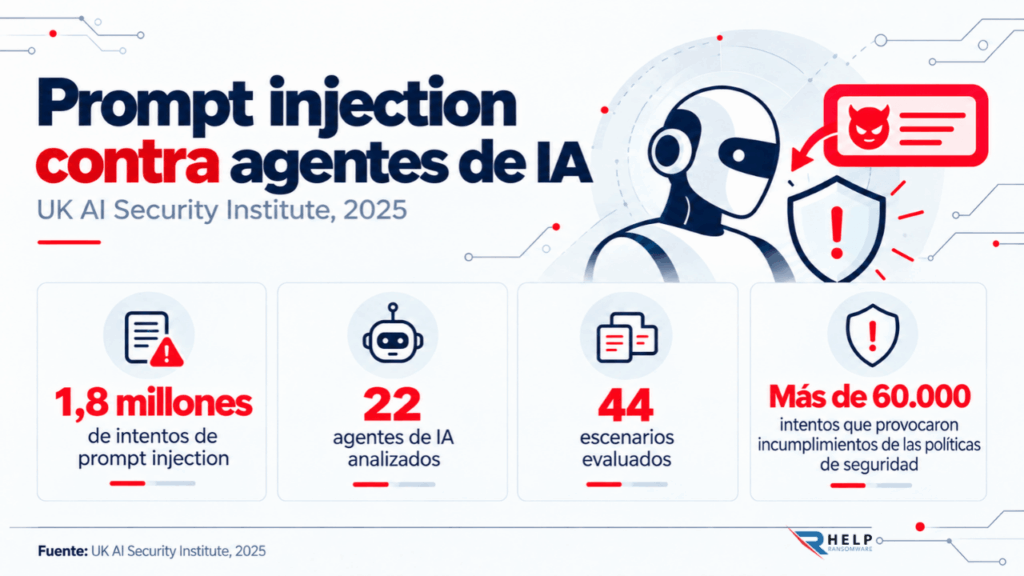
El modelo recibe ese texto como parte de la documentación recuperada y puede confundirlo con una orden legítima. Este patrón se conoce como prompt injection indirecto, una variante de prompt injection.
El NCSC del Reino Unido explica esta debilidad: los modelos de lenguaje no garantizan una separación técnica estricta entre los datos proporcionados y las instrucciones que deben obedecer. Un filtro de frases sospechosas, por sí solo, no elimina el riesgo.
Documentos contaminados y resultados sesgados
Otra vía es el data poisoning aplicado a fuentes de recuperación. El atacante puede introducir políticas falsas, modificar fechas o suplantar la versión vigente de un procedimiento.
También puede cargar documentación que se posiciona como especialmente relevante en las búsquedas. Así, respuestas erróneas pueden adquirir apariencia de respaldo documental.
La diferencia es importante: un documento manipulado no implica necesariamente que el modelo haya sido reentrenado. La contaminación ocurre en la base de conocimiento consultada. Es una variante práctica del riesgo analizado en data poisoning.
Riesgos de seguridad para los datos de la empresa
La manipulación de respuestas puede tener consecuencias operativas: una IA de recursos humanos podría interpretar incorrectamente un procedimiento; una herramienta legal, citar una cláusula inexistente; o un asistente de soporte, recomendar cambios inseguros.
El problema crece cuando esas respuestas desencadenan acciones automáticas o se utilizan sin verificación humana. Además, una respuesta manipulada puede facilitar la exposición de información sensible, decisiones erróneas o accesos indebidos, ampliando el impacto más allá del propio sistema de IA.
Filtraciones por permisos y bases vectoriales compartidas
En un entorno con múltiples departamentos, la búsqueda no debe mostrar fragmentos simplemente porque coinciden con la pregunta. Debe comprobar quién solicita la información, qué documentos puede consultar y si esos permisos siguen vigentes.
Una base vectorial compartida sin controles adecuados puede mezclar información financiera, laboral o contractual entre usuarios.
OWASP identifica estas debilidades como LLM08:2025 Vector and Embedding Weaknesses y recomienda segmentación lógica, permisos granulares, validación de fuentes y registros de recuperación. Su guía oficial sobre riesgos de vectores y embeddings es especialmente pertinente para aplicaciones RAG empresariales.
Tampoco basta con ocultar una respuesta en la interfaz: los permisos deben aplicarse antes de recuperar los fragmentos. Si el sistema recibe contenido restringido en su contexto, ya existe una exposición potencial que merece investigación.
Cómo reforzar la seguridad en sistemas RAG
La prevención comienza antes de que el documento llegue al índice. La empresa necesita un inventario de fuentes, responsables de publicación, clasificación de sensibilidad y criterios claros para aceptar, modificar o retirar archivos.
Las pruebas deben cubrir tanto la precisión de la respuesta como la posibilidad de abuso. También conviene aplicar controles de acceso, validación de documentos y monitoreo continuo para detectar cambios sospechosos o contenido manipulado dentro de la base de conocimiento.
Validar fuentes y controlar cada actualización
Conviene mantener versiones verificables, validar archivos nuevos, detectar texto oculto y conservar trazabilidad de quién incorporó cada cambio.
Cuando se actualiza una política, deben revisarse los fragmentos indexados para evitar que una versión antigua siga apareciendo como vigente. La respuesta puede mostrar referencias, pero las citas no sustituyen la comprobación de autenticidad.
Aplicar mínimo privilegio y límites a las herramientas
El motor de búsqueda debe respetar la identidad y los permisos originales de los repositorios. Es preferible dividir índices por ámbito sensible o aplicar filtros de acceso comprobados antes de entregar contexto al modelo.
Si el asistente puede enviar correos, ejecutar consultas o modificar registros, esas acciones deben pasar por autorizaciones técnicas independientes del texto generado.
Medir ataques, registrar eventos y probar la recuperación
Las pruebas de seguridad deberían incluir documentos con instrucciones adversariales, intentos de consulta entre departamentos, resultados falsificados y peticiones que buscan sacar información de la organización.
Registrar documentos recuperados, versiones, usuario, respuesta y acciones realizadas facilita identificar la ruta de un incidente.
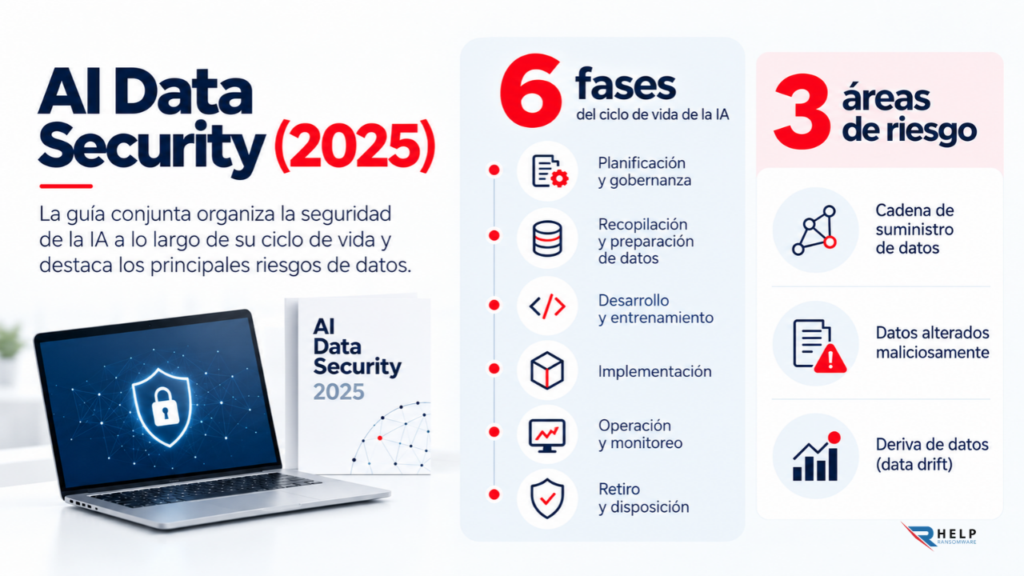
La guía conjunta de seguridad de datos para IA publicada en 2025 por agencias de Estados Unidos, Australia, Nueva Zelanda y Reino Unido insiste en proteger los datos durante todo el ciclo de vida, con validación, control de acceso, trazabilidad y seguimiento continuo. El documento puede consultarse en AI Data Security, portal oficial del Gobierno australiano.
Qué hacer si tu asistente RAG ya muestra respuestas manipuladas
Si aparecen respuestas extrañas, citas imposibles o información de otros departamentos, conviene detener temporalmente el acceso a las fuentes sospechosas y preservar evidencias. El equipo debe identificar la consulta afectada, los fragmentos recuperados, su procedencia y las identidades que pudieron recibir información no autorizada.
Después hay que retirar o poner en cuarentena el contenido comprometido, reconstruir los índices necesarios, revisar permisos y contrastar los resultados con documentación auténtica.
Si hubo acceso indebido o fuga de datos, el caso debe tratarse como un incidente de seguridad, activando el plan de respuesta ante ciberataques y los procesos legales que correspondan.
No es suficiente cambiar una instrucción del chatbot y continuar. La recuperación exige confirmar que la fuente alterada ya no aparece, que los índices se han actualizado y que las pruebas adversariales no reproducen el fallo.
Especialistas en Eliminación de Ransomware
Nuestros profesionales certificados cuentan con más de 25 años de experiencia en la eliminación de ransomware, recuperación de datos y seguridad informática.
Conclusión
Un sistema RAG puede facilitar el acceso a conocimientos corporativos, pero también permite que el contenido externo influya directamente en lo que responde la IA. Proteger el modelo sin proteger documentos, permisos, vectores y registros deja abierta una superficie de ataque importante.
La seguridad en sistemas RAG se construye con fuentes fiables, controles de acceso reales, pruebas de manipulación y un proceso de respuesta definido.
Para las organizaciones que integran IA en operaciones críticas, evaluar estos controles antes del despliegue es tan importante como medir la utilidad del asistente.
FAQ
Sí. Basta con que consulte documentos manipulados o no autorizados para que una respuesta pueda verse afectada. El riesgo reside en la recuperación y el uso del contenido, no necesariamente en el entrenamiento. Por eso, también deben protegerse las fuentes y los mecanismos que incorporan información al sistema.
No. Las citas ayudan a revisar lo recuperado, pero una fuente también puede estar manipulada. Hay que validar su procedencia y evitar que el modelo trate instrucciones ocultas como órdenes. También conviene limitar qué contenidos pueden influir en el comportamiento del sistema durante la recuperación.
Aplicando controles de acceso en la búsqueda, vinculados a la identidad del usuario y al permiso real sobre cada documento. La interfaz por sí sola no debe decidir qué fragmentos se recuperan.
No siempre. También deben eliminarse los fragmentos y vectores derivados, actualizar índices y cachés, revisar las consultas afectadas y verificar que el contenido ya no aparece en las respuestas.
La responsabilidad es compartida: IT administra infraestructura y permisos; seguridad prueba abusos y monitoriza; las áreas propietarias de datos validan contenidos; y dirección define tolerancia al riesgo y supervisión.